Per vent'anni farsi trovare online ha voluto dire una cosa sola: comparire tra i primi risultati di Google. Oggi molte ricerche prendono un'altra strada.
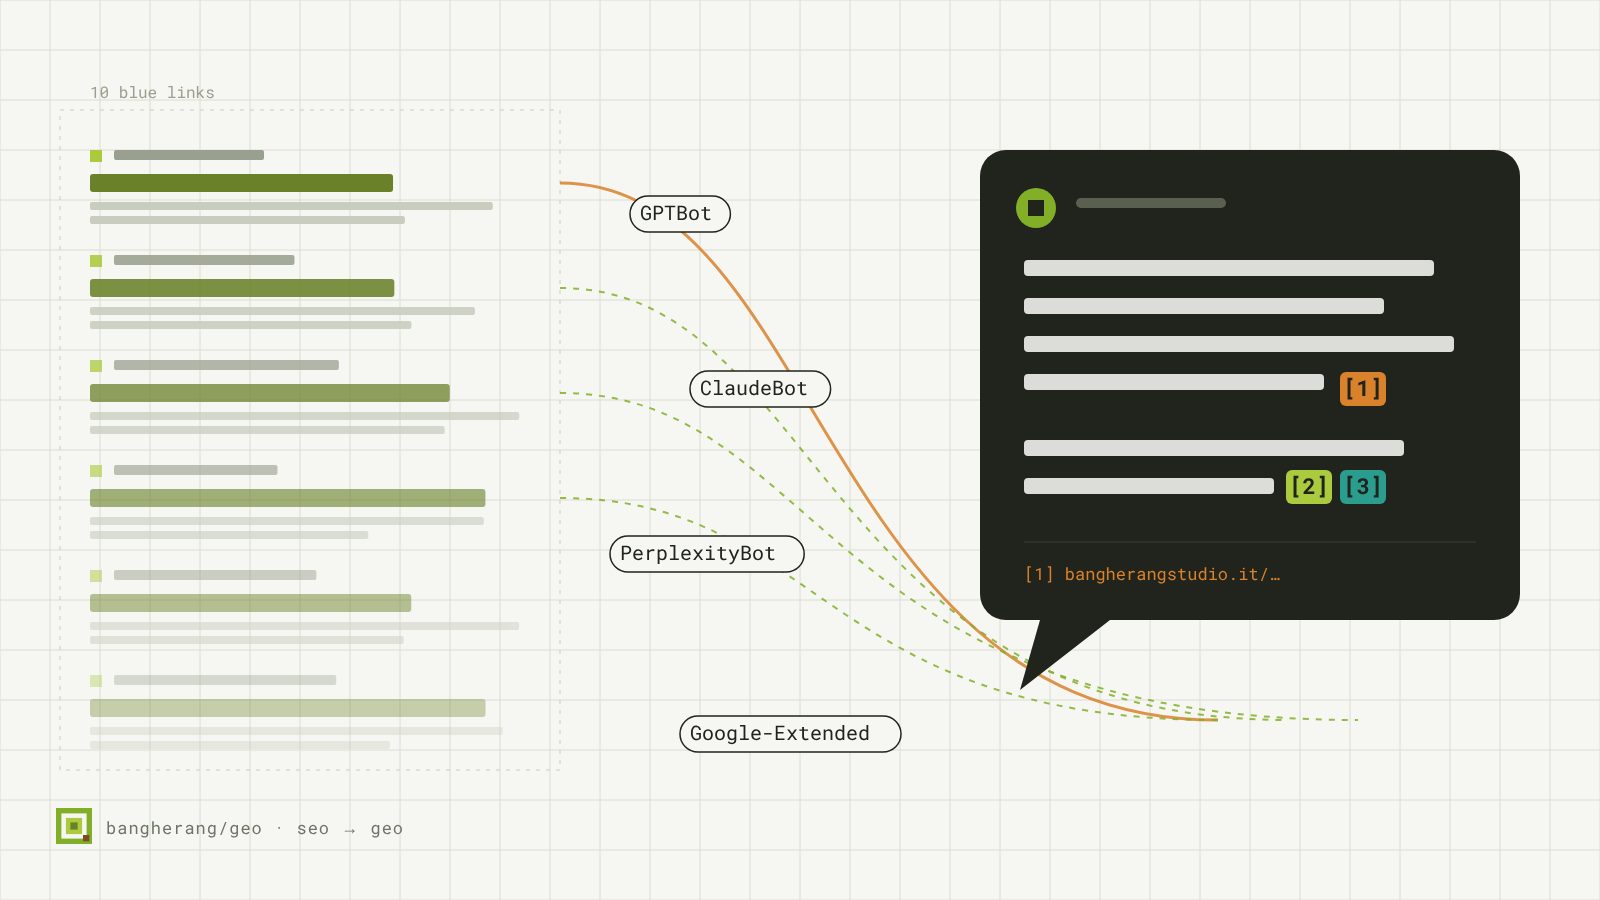
Le persone fanno la domanda a ChatGPT, a Claude, a Perplexity, oppure leggono la risposta generata che Google mette sopra i link. E un assistente risponde con un paragrafo e cita poche fonti, a volte nessuna. Chi non è tra quelle, per chi ha chiesto, non esiste.
Cos'è la GEO
GEO sta per Generative Engine Optimization. Vuol dire lavorare su un sito perché i motori generativi, cioè gli assistenti che scrivono risposte, lo leggano bene, lo capiscano e lo citino.
La SEO classica resta viva. Google continua a portare visite, e un sito lento, con titoli confusi o contenuti doppi va male in tutti e due i mondi. Serve ancora, però da sola non basta più.
Cosa abbiamo fatto sul nostro sito
Abbiamo rifatto bangherangstudio.it tenendo a mente gli assistenti oltre a Google. Queste sono le scelte concrete.
Pagine complete già dal server
Ogni pagina esce dal server già scritta per intero, grazie al rendering lato server con Blade, il sistema di template di Laravel. Il motivo è pratico: i crawler GPTBot, ClaudeBot e PerplexityBot, i programmi che leggono il web per conto degli assistenti, non eseguono JavaScript.
Un sito costruito tutto in JavaScript, nel browser di un visitatore, sembra normale. A quei crawler invece arriva una pagina vuota con uno script dentro, e niente da citare.
Porte aperte nel robots.txt
Il robots.txt è il file che dice ai crawler dove possono andare. Nel nostro i bot degli assistenti sono invitati per nome:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

Sitemap: https://www.bangherangstudio.it/sitemap.xml
Lo stesso vale per Google-Extended e Applebot-Extended, le voci con cui Google e Apple chiedono il permesso di usare i contenuti per i loro modelli.
Un file llms.txt
Abbiamo pubblicato un llms.txt, una proposta di standard ancora giovane che serve a dare ai modelli linguistici un riassunto del sito in testo pulito. Il nostro racconta chi siamo e cosa facciamo, in italiano e in inglese.
Dati strutturati
Le informazioni sullo studio e sui servizi sono descritte anche in JSON-LD, un formato di dati strutturati che i motori leggono senza dover interpretare il testo. Nome, sede e servizi stanno scritti in un campo preciso, e nessuno deve indovinarli da un paragrafo.
Domande frequenti pronte da citare
Le FAQ sono marcate con il dato strutturato FAQPage. Le risposte principali hanno anche speakable, la proprietà che indica i passaggi adatti a essere letti ad alta voce dagli assistenti vocali.
Due lingue, dichiarate
Ogni pagina italiana è collegata alla sua versione inglese con hreflang, l'attributo che dice ai motori quale versione mostrare a chi. Chi chiede in inglese trova la pagina in inglese.
Da dove partire con il vostro sito
Il primo controllo si fa in un minuto. Aprite il codice sorgente di una pagina (Ctrl+U nel browser) e cercate una frase che leggete a schermo. Se nel sorgente non c'è, nemmeno i crawler degli assistenti la vedono.
Il secondo è il robots.txt: aggiungete /robots.txt all'indirizzo del sito e guardate chi è ammesso e chi no. Capita di trovare bloccati proprio i bot che vi servono.
Il resto, dati strutturati e testi scritti per essere citati, è lavoro più lungo. Ne parliamo nella nota dedicata a come scriviamo le pagine.